

7月30日下午,2026人工智能產品應用博覽會(以下簡稱"2026智博會")同期專題活動——"模數共振:高質量數據集賦能人工智能應用"在蘇州工業園區成功舉辦。
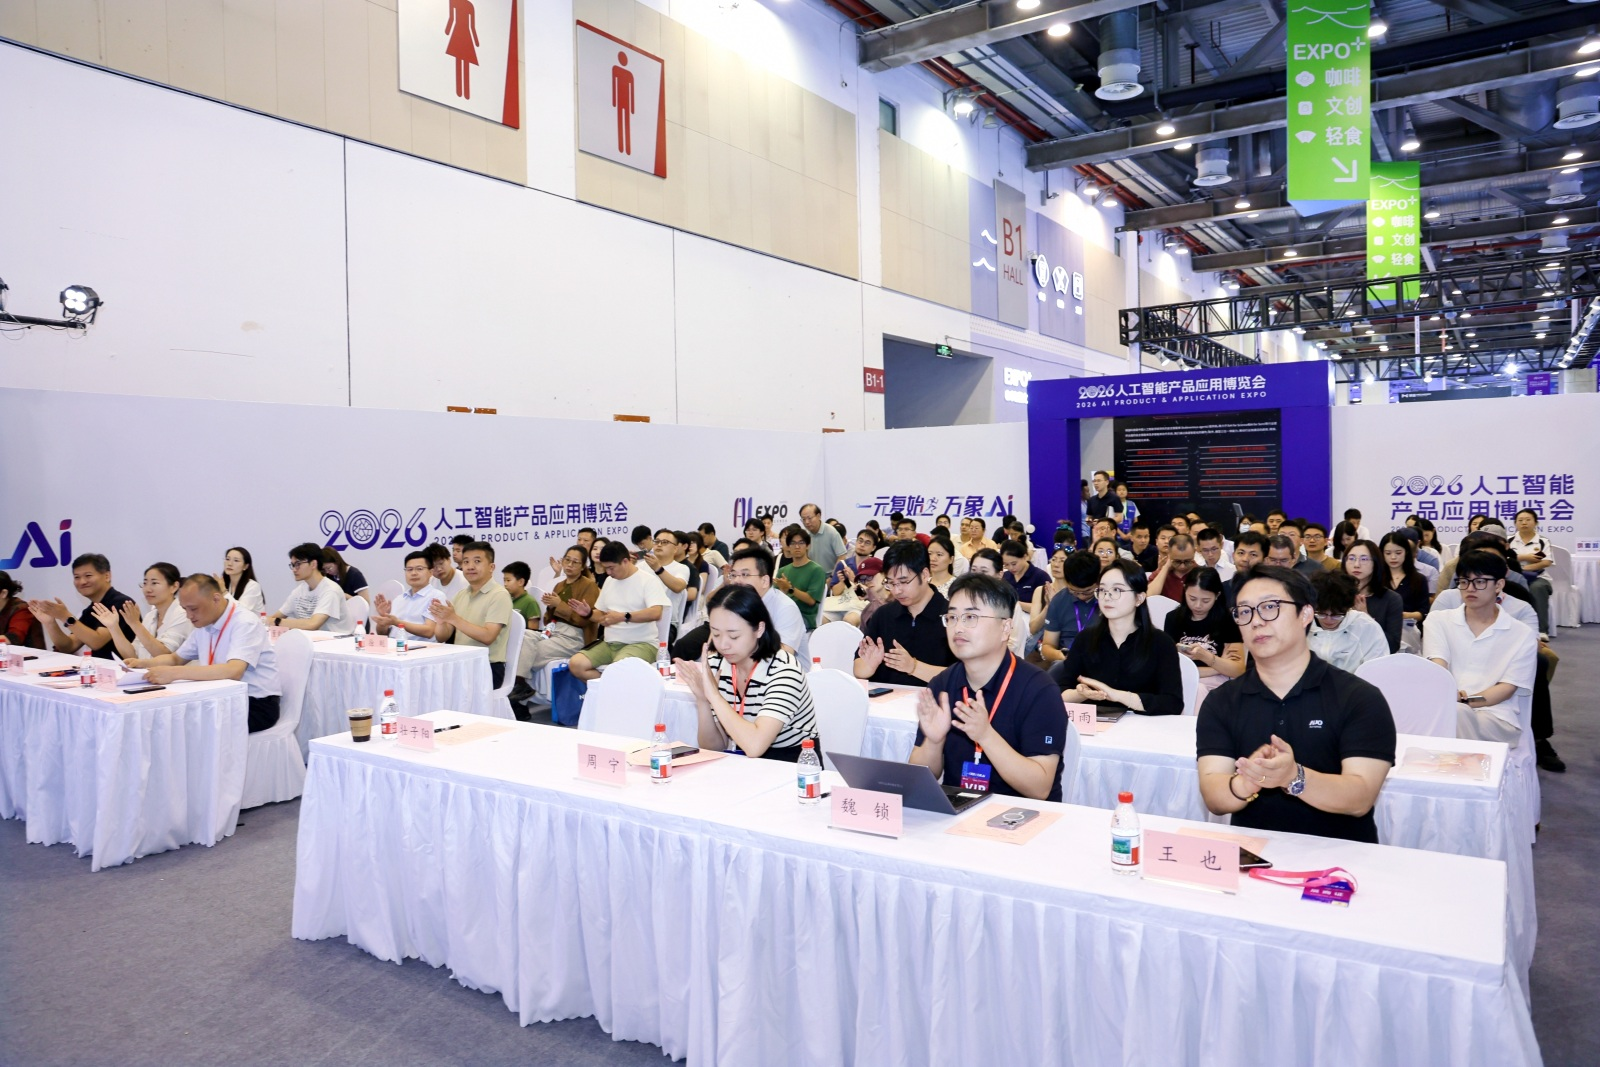
本屆智博會以"一元復始萬象AI"為主題,于7月30日至8月1日在蘇州舉辦。本次專題活動由江蘇風云科技服務有限公司、賽昇數智科技(蘇州)有限公司聯合承辦,江蘇省工業和信息化廳、蘇州市工業和信息化局相關領導出席,來自政府部門、高校智庫、行業龍頭企業的眾多嘉賓與參會代表齊聚一堂,圍繞高質量數據集建設與人工智能應用落地展開深度對話,共探數據與模型協同互促的創新路徑。
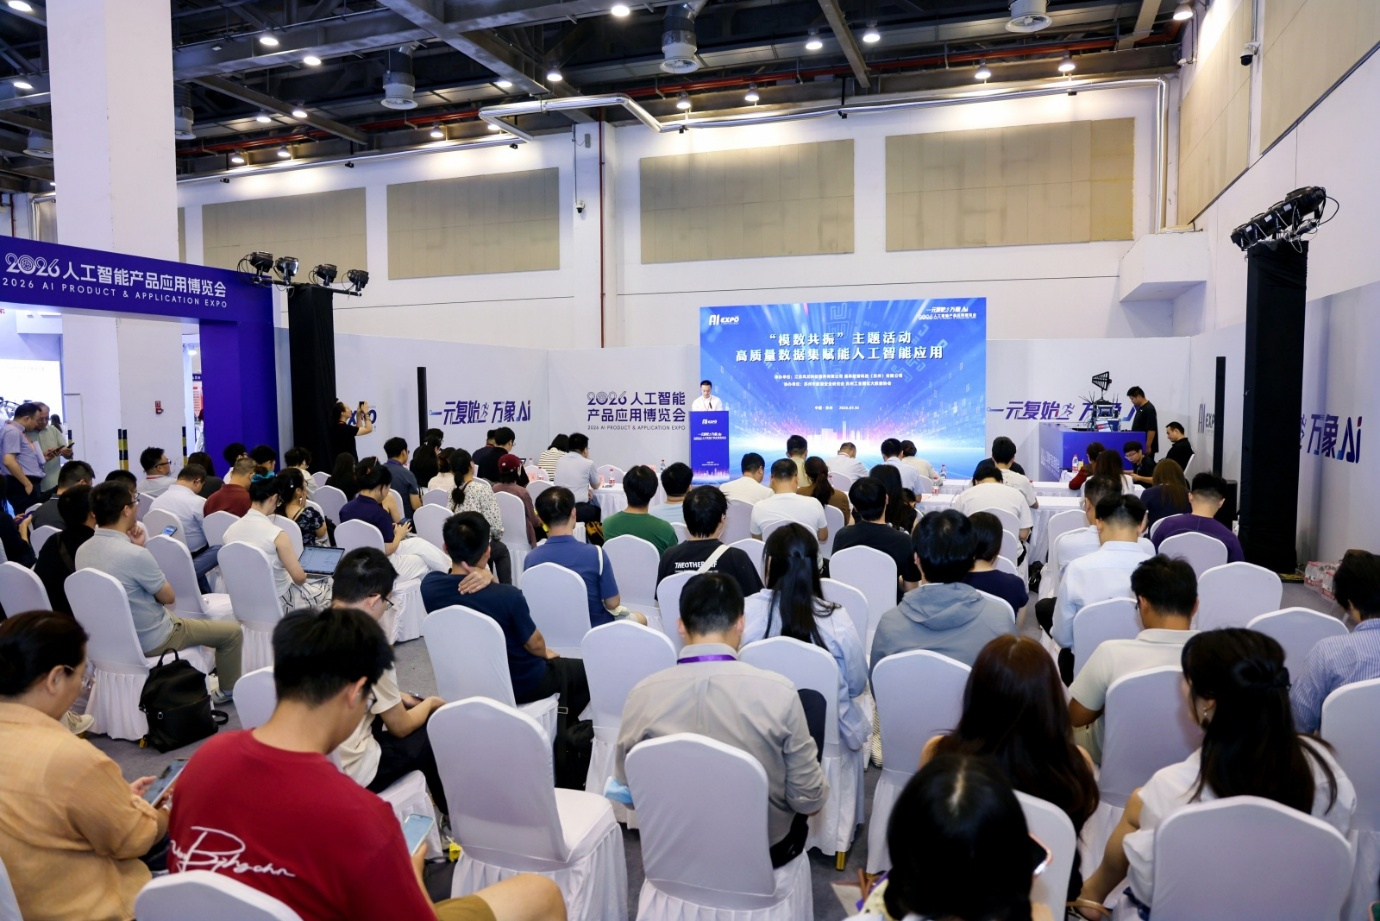
活動伊始,蘇州國際科技園(SISPARK)董事長壯子陽對各位領導、專家和業界同仁的到來表示熱烈歡迎,并介紹了蘇州工業園區在人工智能、大模型和數據要素產業方面的發展成效,期待以本次活動為契機,進一步推動數據與模型深度融合,助力園區人工智能及數字產業生態建設。
權威解讀
從"三地先行"到"全省共進",江蘇"模數共振"路線清晰
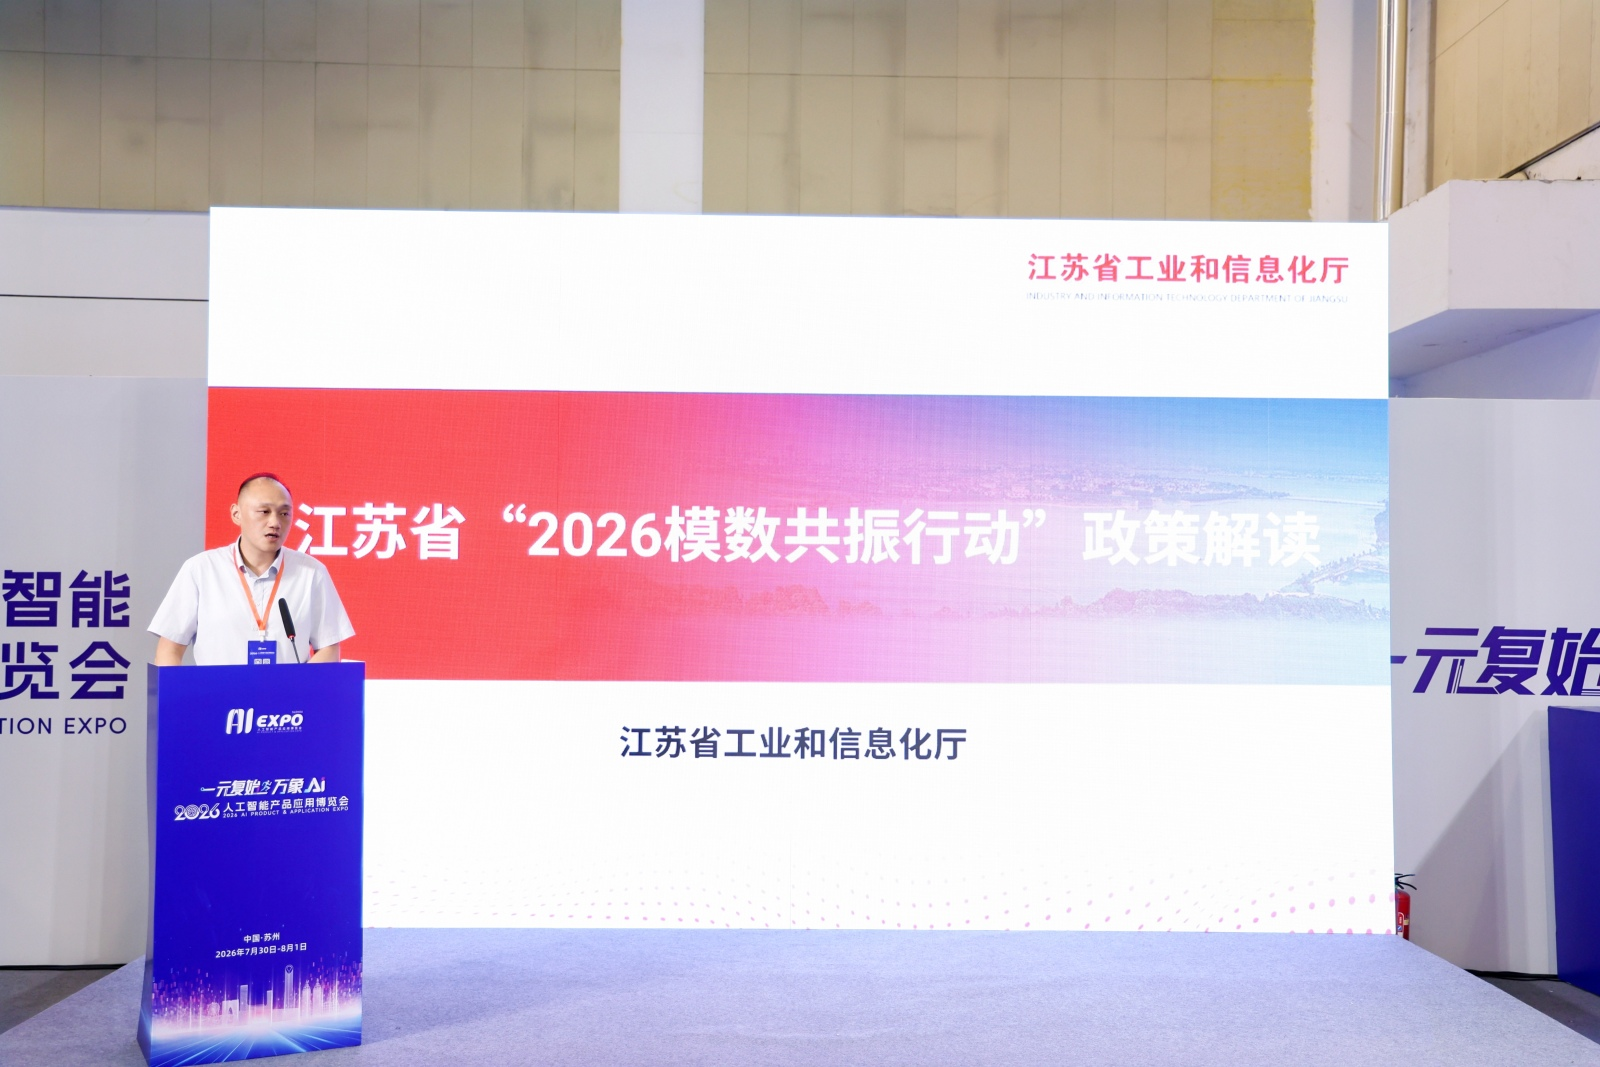
活動現場,江蘇省工業和信息化廳人工智能與大數據產業處副處長孫飛作江蘇省"2026模數共振行動"政策解讀。孫飛指出,當前人工智能與制造業融合正從"概念普及"邁向"深度應用",但仍面臨數據孤島化問題突出、模型泛化適配性不足、場景落地成本居高不下三大瓶頸;"模數共振"行動瞄準上述痛點,從數據集建設、模型攻關、場景適配全鏈條發力,實現"以模引數、用數賦模"的良性循環。今年4月,工業和信息化部、國家數據局聯合啟動2026年"模數共振"行動,面向鋼鐵、工業母機、汽車、航空航天、信息通信等20個重點行業,明確到2026年底基本形成"數據—模型—場景應用"良性互促的發展格局。
江蘇制造業規模連續多年位居全國前列,覆蓋全部31個制造業大類,制造業高質量發展指數連續五年居全國首位,14個集群入選國家先進制造業集群、數量全國第一;2025年全省人工智能相關企業超1500家、相關產業規模超4500億元。今年6月,江蘇按照國家統一部署,遴選南京、蘇州、無錫三市,圍繞鋼鐵、軟件、電子元器件、新型顯示、電力裝備五大行業,率先啟動國家"模數共振"先行試點,部署構建行業通識數據集與通用行業模型、梳理高價值場景與構建行業專識數據集、建立健全評測數據集、創建"模數共振"空間、打造創新聯合體、完善生態配套體系等重點任務。到今年11月底,三市先行試點將累計建成行業通識數據集和行業專識數據集超200個,形成行業模型、專用模型或特色智能體超180個,形成可復制、可推廣的典型經驗和應用案例超500個。
孫飛介紹,下一步江蘇將推動行動從"三地先行"向"全省共進",組織全省13個設區市聚焦"1650"產業體系重點產業鏈逐步拓展行業范圍,到2030年構建不少于100個工業和信息化領域行業高質量數據集建設聯合體,打造不少于1000個行業模型、專用模型或特色智能體;并同步推進《江蘇省人工智能產業發展促進條例》立法進程、印發《江蘇省人工智能產業創新發展行動方案(2026—2030年)》,從體制機制、數模雙輪驅動、場景牽引、生態優化四個方面保障行動落地見效。
學術前沿
全球政策比較視野下的高質量數據集建設
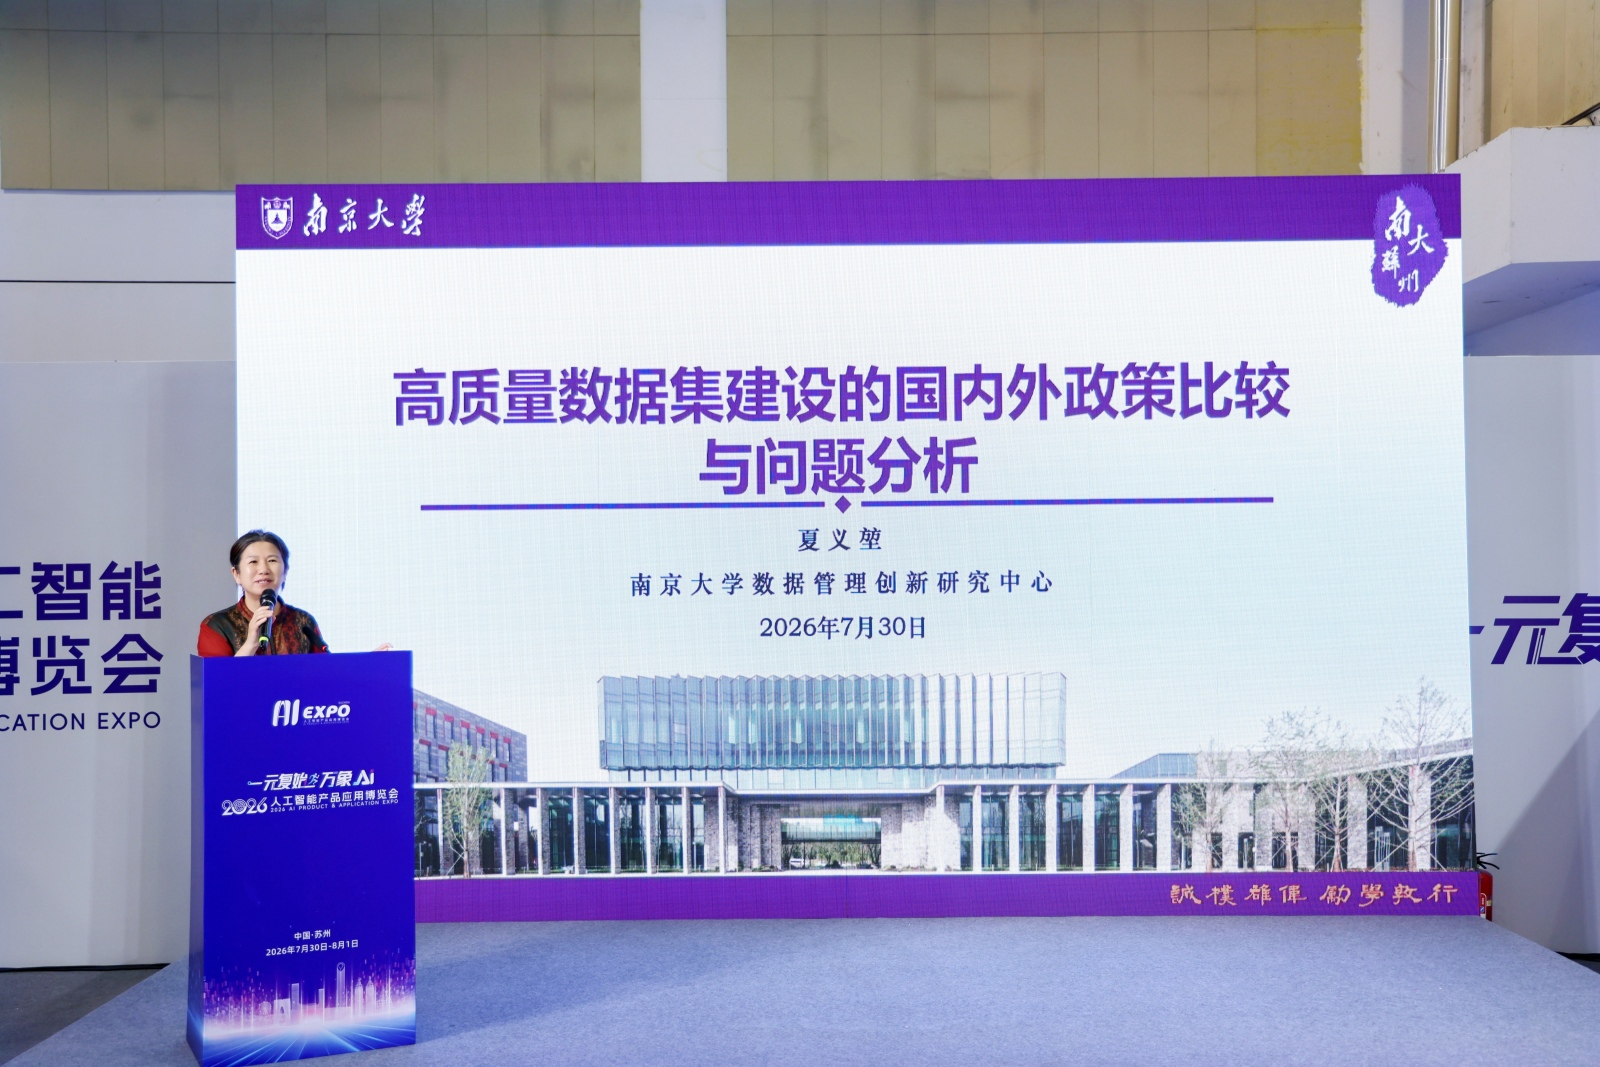
南京大學數據管理創新研究中心教授夏義堃以《高質量數據集建設的國內外政策比較與問題分析》為題作專題分享。夏義堃援引EpochAI評估指出,支撐大模型訓練的公域數據資源預計將在2028年耗盡,而占數據總量約90%的私域數據卻受限于流通機制、治理體系等問題無法得到充分高效利用;Gartner調查亦顯示,目前仍有68%的企業數據未被分析利用,82%的企業仍處數據孤島之中,高質量數據供給已成為AI競爭的戰略制高點。值得注意的是,中國開源AI模型在全球最大AI開源社區HuggingFace的下載量占比已達17.1%,歷史性反超美國的15.8%,"開源技術深度應用—產業數據反哺迭代—全球生態標準輸出"的價值閉環正在形成。
在政策比較部分,夏義堃系統梳理了國內外最新進展:我國已形成"國家定標準、地方給支持、行業抓落實"的政策協同格局,國家數據局今年6月印發的《關于推進行業高質量數據集建設行動的實施方案》部署強基擴容、標注攻堅、提質增效、應用賦能、管理服務、價值釋放六大專項行動,全國數據標準委員會《高質量數據集建設指南》《高質量數據集格式要求》《高質量數據集分類指南》《高質量數據集質量評測規范》等系列標準相繼發布,其中質量評測明確說明文檔、數據質量、模型應用三個維度指標得分均需達到90分及以上方可認定為高質量數據集;國際上,美國以"創世紀計劃"整合聯邦科學數據集打造國家AI基礎設施,英國以國家數據圖書館、健康數據研究服務構建"輕立法、重平臺"路徑,歐盟依托《數據法案》《人工智能法案》建設共同數據空間與AI工廠,日本《AI推進法》首次將數據集等知識產權基礎寫入國家應建設的AI基礎設施。針對建設難題,夏義堃提出織密"數據匯聚網"、打造"數據金標尺"、深挖"數據價值礦"、搭建"數據信任橋"的破局之道,并提醒業界:從"模型狂熱"轉向"數據務實"的道路還很漫長,獨特的內部數據將成為企業AI競爭力的關鍵來源。
方法論指引
以評促建、以測提質,構建全生命周期建設運營體系
賽昇數智科技(蘇州)有限公司運營總經理魏鎖以《模數協同下的高質量數據集建設路徑》為題作分享。魏鎖指出,業界共識已從"以模型為中心"全面轉向"以數據為中心",當前產業發展的核心矛盾,是快速增長的行業高質量數據集需求與滯后的系統性建設運營能力之間的矛盾。高質量數據集的高質量體現在規模"大"、安全"牢"、觀點"正"、效果"好"、應用"廣"等方面,預訓練數據集為工業大模型"開智",后訓練數據集為工業大模型"增智"。
圍繞建設運營路徑,魏鎖提出場景驅動與數據驅動螺旋式發展的建設模式,提煉"盤、建研、管、運"五步法,通過場景化工業數據采集、機理融合數據預處理、工況導向數據增強融合、行業適配全生命周期質量管控,實現從"數據可用"到"數據集可信、可解釋、可建模"的躍升;并構建覆蓋組織管理、工程建設、質量管控、安全合規、技術工具、運營管理六大能力域、五個等級的數據集運營能力成熟度模型,為企業指引動態提升路徑。作為國家工業信息安全發展研究中心的下屬單位,賽昇數智還依托《人工智能數據集質量評價指標》標準開展數據集質量測評,構建了4項一級、18項二級、30項三級指標體系,并已基于大模型安全測試平臺完成8款國產旗艦大模型安全測評。活動現場,魏鎖代表中心正式啟動"大模型安全測評基準共建行動",面向全行業征集共建單位,合力打造全維度、系統化的人工智能安全評測體系。
產業實踐
工業裝備、智能制造、生物醫藥、公共數據,四大領域標桿案例集中亮相
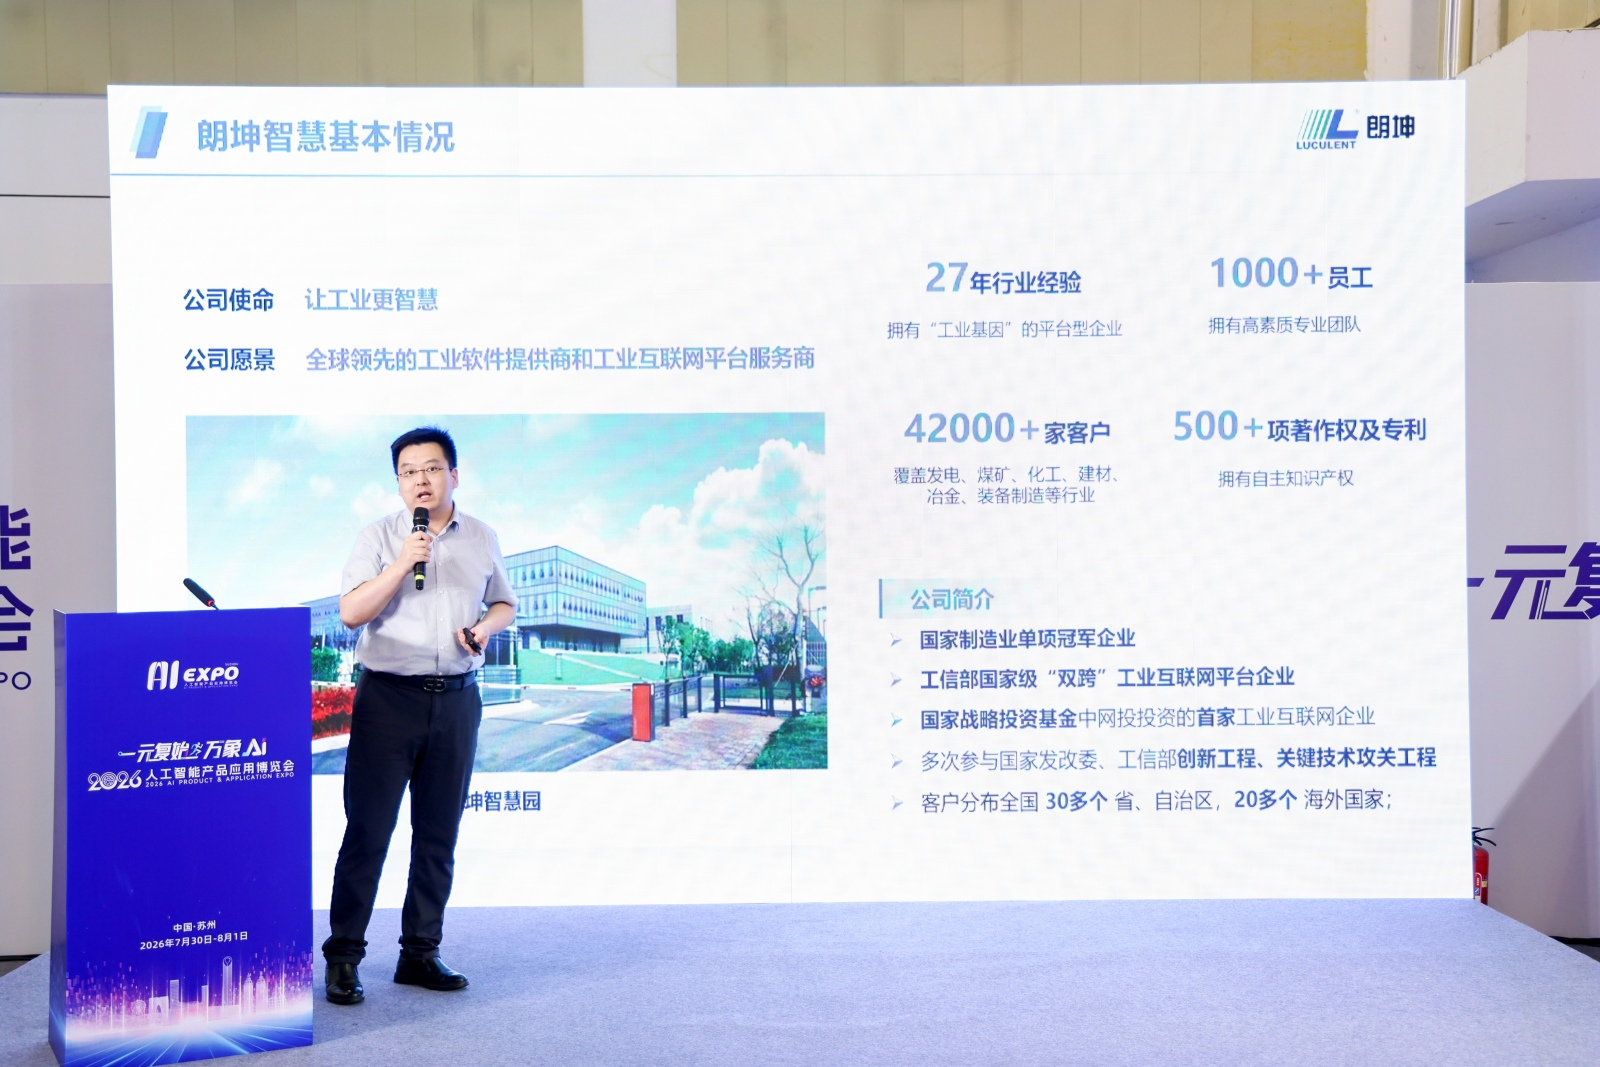
工業裝備領域,朗坤智慧科技股份有限公司產品總監李峰丞分享《工業數據筑基在煤機、新能源裝備行業領域的先行先試與融合實踐》。朗坤智慧沉淀出"一組高質量數據集、一批'實專'模型、一套數據采集用工具鏈、一套數智創新方法論"的建設經驗,打造12個多模態數據采、集、用工具包,內置300余個建模組件;在煤機領域,牽頭制定1項國家標準、4項團體標準、2項企業標準,構建覆蓋設計參數、生產制造、狀態監測、維護檢修等全要素的煤機裝備多模態高質量數據集,融合機理小模型與基于蘇暢瑤光大模型的煤炭垂域大模型,故障預警小模型準確性達93%、大模型達85%,已賦能中國中煤、中國煤炭科工、華電煤業等40余家客戶,接入設備超3萬臺,落地智能體28個、智能預警案例超1300個;在風電等新能源裝備領域,統一測點點表、故障編碼、機組狀態字等數據標準,構建風電行業多模態高質量數據集,推動裝備運維從"被動維修"走向"主動防御"。
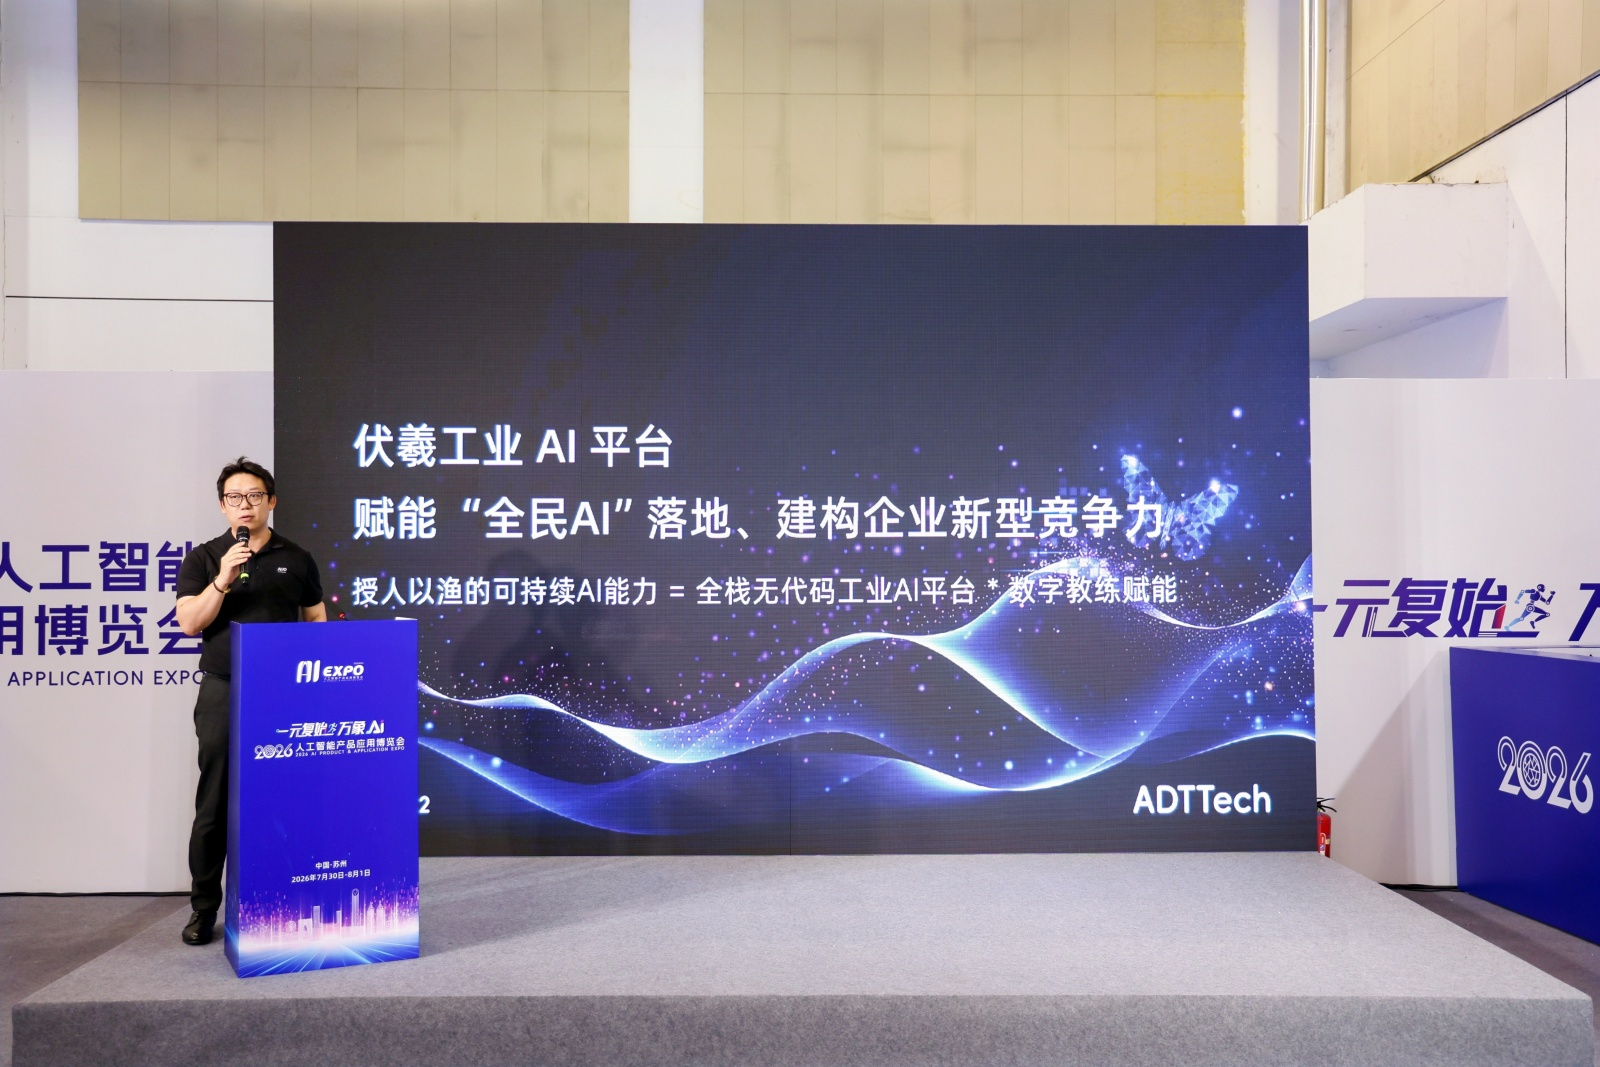
智能制造領域,達智匯科技服務(蘇州)有限公司戰略發展總經理王也以《伏羲工業AI平臺賦能"全民AI"落地、建構企業新型競爭力》為題作分享。王也指出,85%的企業AI項目未能達到預期,落地最大的阻礙并非算力與算法,而是占七成的用戶意愿、流程變更與管理技能等隱性壁壘,企業需要的不是一次性的外部模型交付,而是自主掌控的工業AI創新能力引擎。達智匯伏羲工業AI平臺以伏羲智算(機器學習)、伏羲智眸(深度學習)、伏羲智擎(生成式AI)三大技術引擎為支撐,配套UAD數字教練賦能體系,讓業務專家無需編程即可"一天上手、一周落地",重點破解占企業需求80%的一線業務級AI議題;平臺算力支持本地私有化部署,確保核心數據資產"絕對不出廠",并提供覆蓋企業八大業務部門的500余個AI場景模板。目前,伏羲平臺已助力友達光電(蘇州)獲評世界經濟論壇(WEF)全球顯示器產業首家"燈塔工廠",并在某百億級跨國汽車零部件龍頭企業實現一期預期直接收益500萬元/年、二期海外工廠平展預期年收益1000萬元的賦能成效。
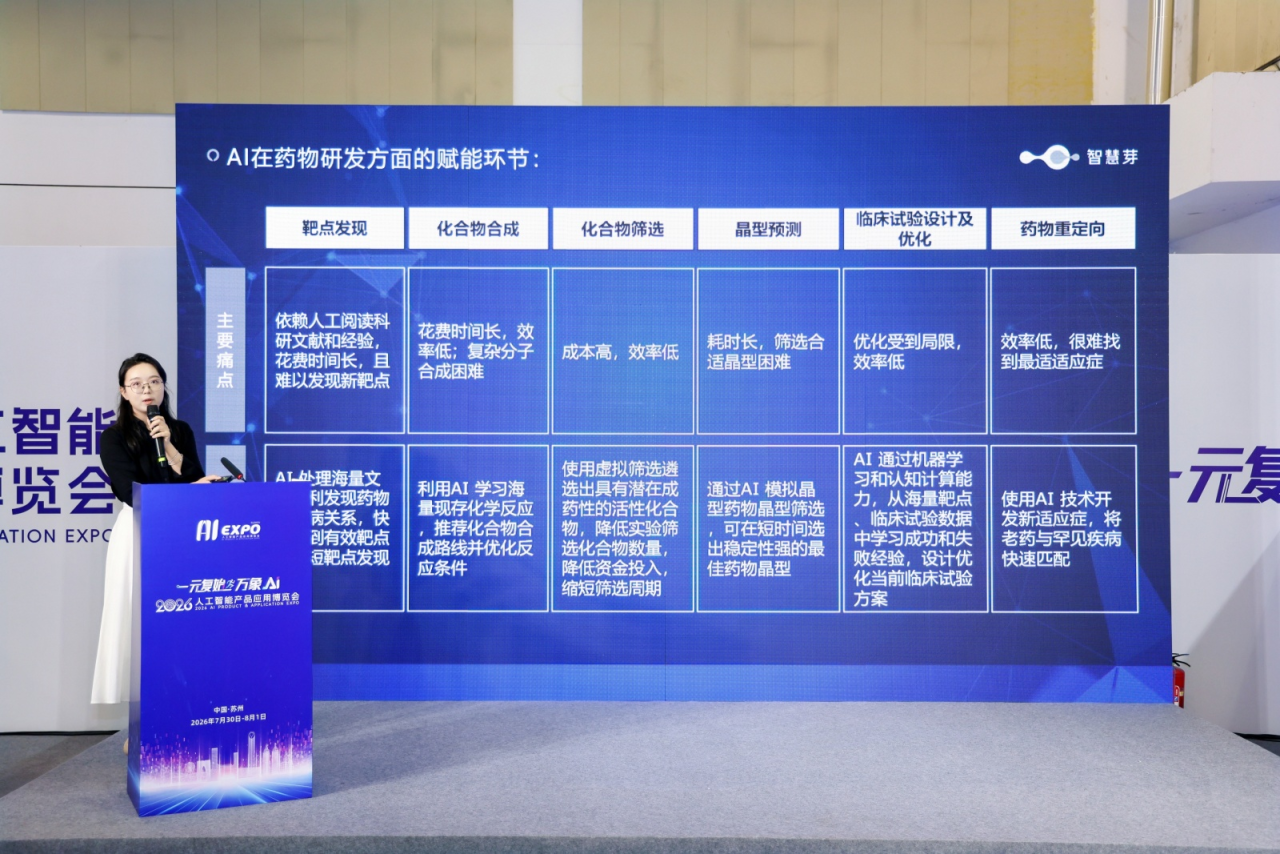
生物醫藥領域,智慧芽信息科技(蘇州)有限公司生物醫藥AI專家朱明雨帶來《生物醫藥科研高質量數據集建設實踐分享》。朱明雨介紹,2026年初頭部藥企AI應用呈現"研發引擎化、平臺生態化、全鏈條滲透"的核心特征,AI已深度賦能靶點發現、化合物合成、化合物篩選、晶型預測、臨床試驗設計及優化、藥物重定向等藥物研發關鍵環節。大模型構建是數據、算法、工程、優化多環節協同的系統工程,智慧芽的大模型語料解決方案聚焦"數據準備"階段,依托新藥情報庫、生物序列數據庫、化學結構數據庫以及專利、文獻、企業數據等數據基座,為AIDD等生成式與預測模型提供高純度訓練底座。在抗體可開發性預測模型訓練案例中,智慧芽從公開源獲取抗體序列、靶向抗原及親和力指標訓練模型,幫助企業建立對候選抗體藥物靶向性、親和力等關鍵參數的預測能力;針對藥企安全合規要求,還可提供支持本地化部署、權限管理與日志審計的定制化知識庫與智能體平臺,實現"專家經驗"的工具化沉淀。
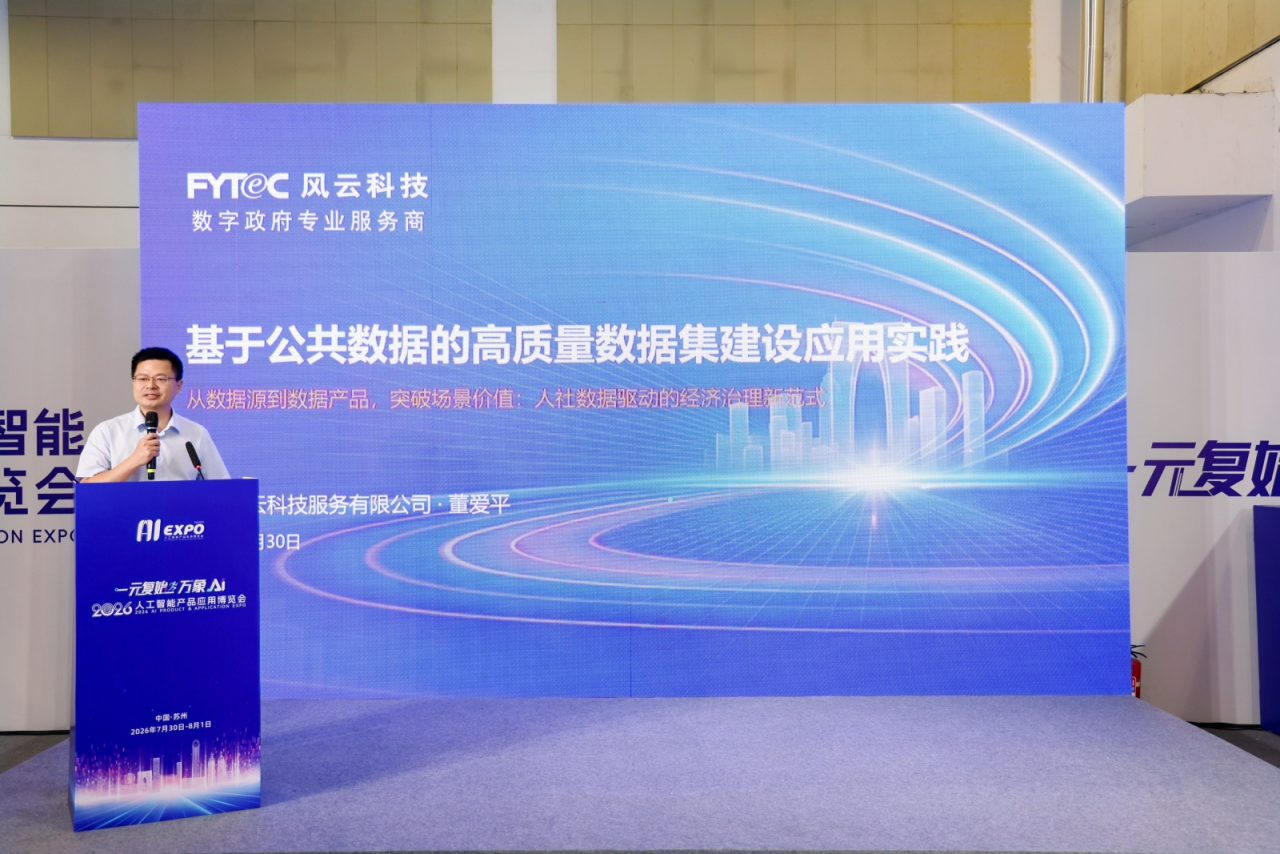
公共數據領域,江蘇風云科技服務有限公司副總經理董愛平以《公共數據高質量數據集建設應用實踐——從數據治理到產業賦能:人社數據驅動的經濟治理新范式》為題作分享。董愛平介紹,今年6月人社部、國家發改委、工信部、國家數據局四部委聯合印發《"人工智能+人社"實施意見》,公共數據高質量開發利用進入政策與產業共振的快車道。風云科技依托"授權開發+治理能力+第三方測評"的三重護城河,以人社數據為"富礦"打造企業外遷風險預警數據產品:通過裁員、停招、檔案轉出、勞動爭議四維信號交叉驗證,實現"1+1+1+1>4"的前瞻性預警,并以加權評分、四級風險分級、雙因子校正將信號轉化為可操作的風險評級;產品采用"數據可用不可見"架構,原始數據不出域、域內聚合計算、輸出結果匿名化,僅對外輸出風險評級等聚合分析結果,實現原始數據不出域、商業秘密不泄露、個人隱私不侵犯三重保障。目前,同一套人社高質量數據集已在經濟治理、金融服務、園區運營、政策決策四大場景同步釋放價值,實現"一數多用"。面向未來,風云科技將積極爭取成為江蘇省人社行業高質量數據集建設的"鏈主單位",持續拓展數據要素生態邊界。
供需對接,從"同頻"走向"共振"。活動最后設置的供需對接交流環節氣氛熱烈。高質量數據集建設的供給方與需求方面對面洽談,圍繞數據集共建、模型共訓、場景共創、測評認證等合作方向深入交流,多家企業現場達成初步合作意向。與會代表普遍認為,本次活動實現了政策解讀、學術研究、方法論指引與產業實踐的全鏈條貫通,為江蘇推進"模數共振"行動落地搭建了高水平的交流合作平臺。
編輯 園網
2026年7月31日


